高阶智驾底座:大模型定义芯片迈入规模化量产新纪元
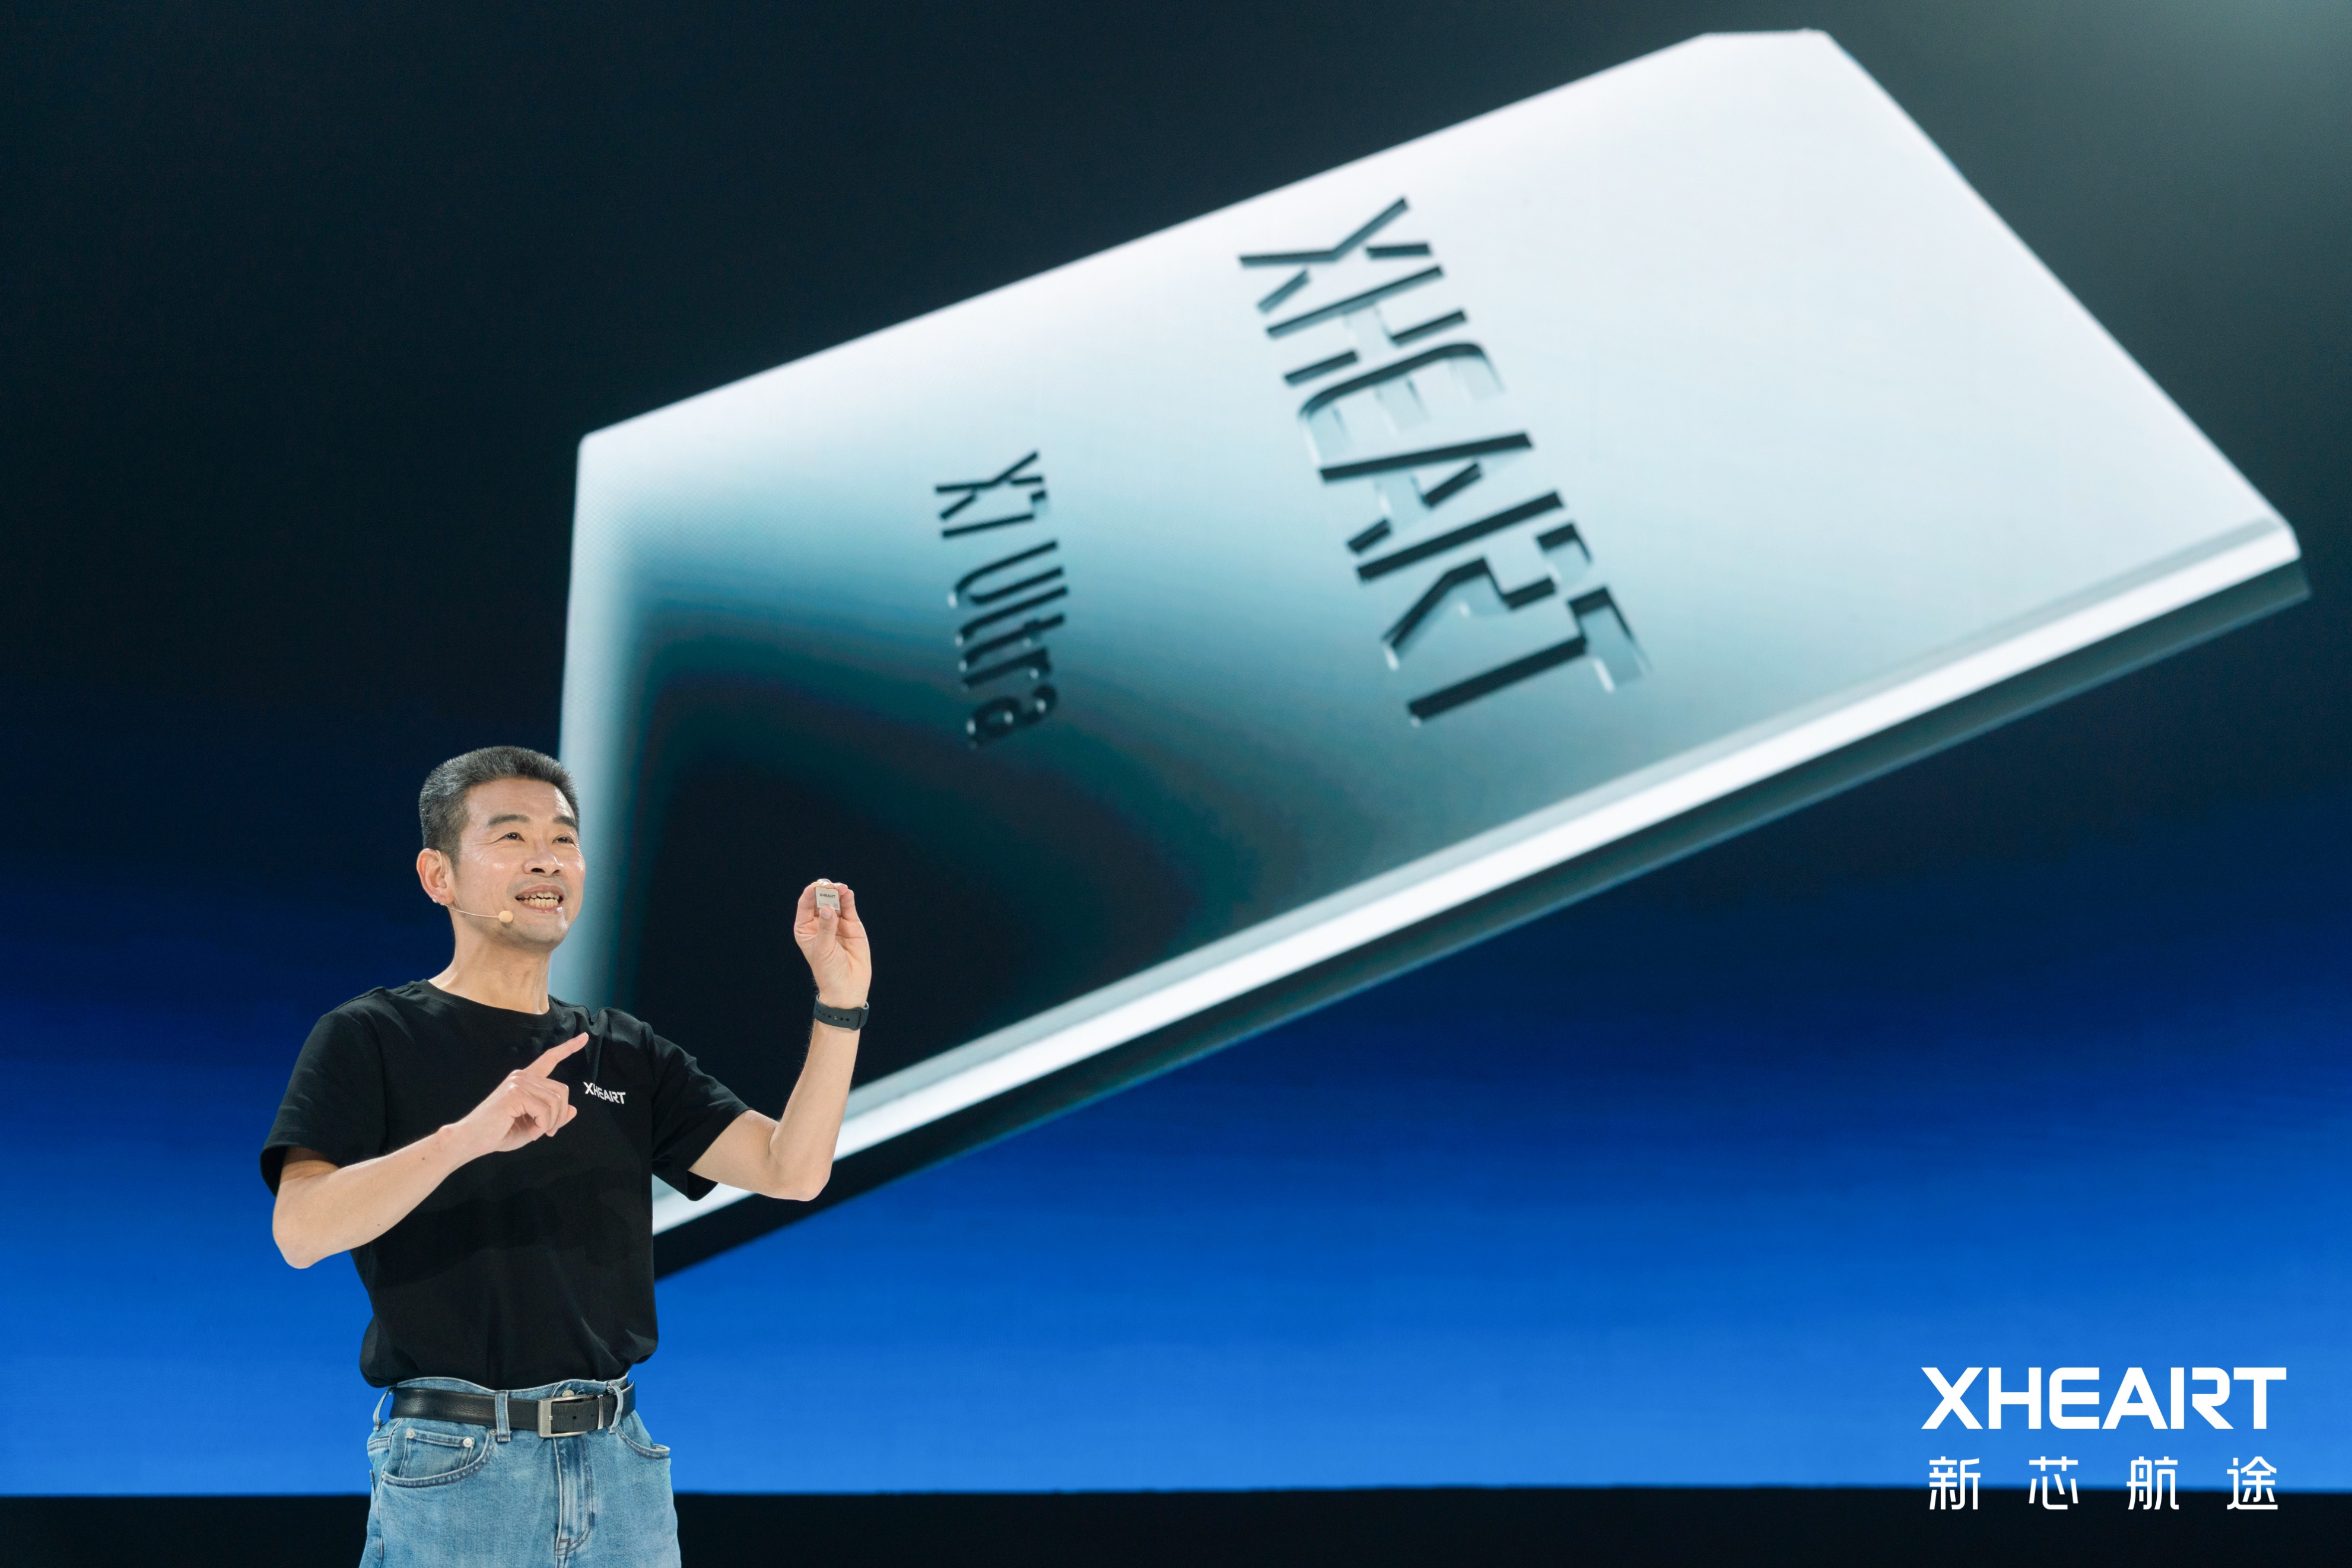
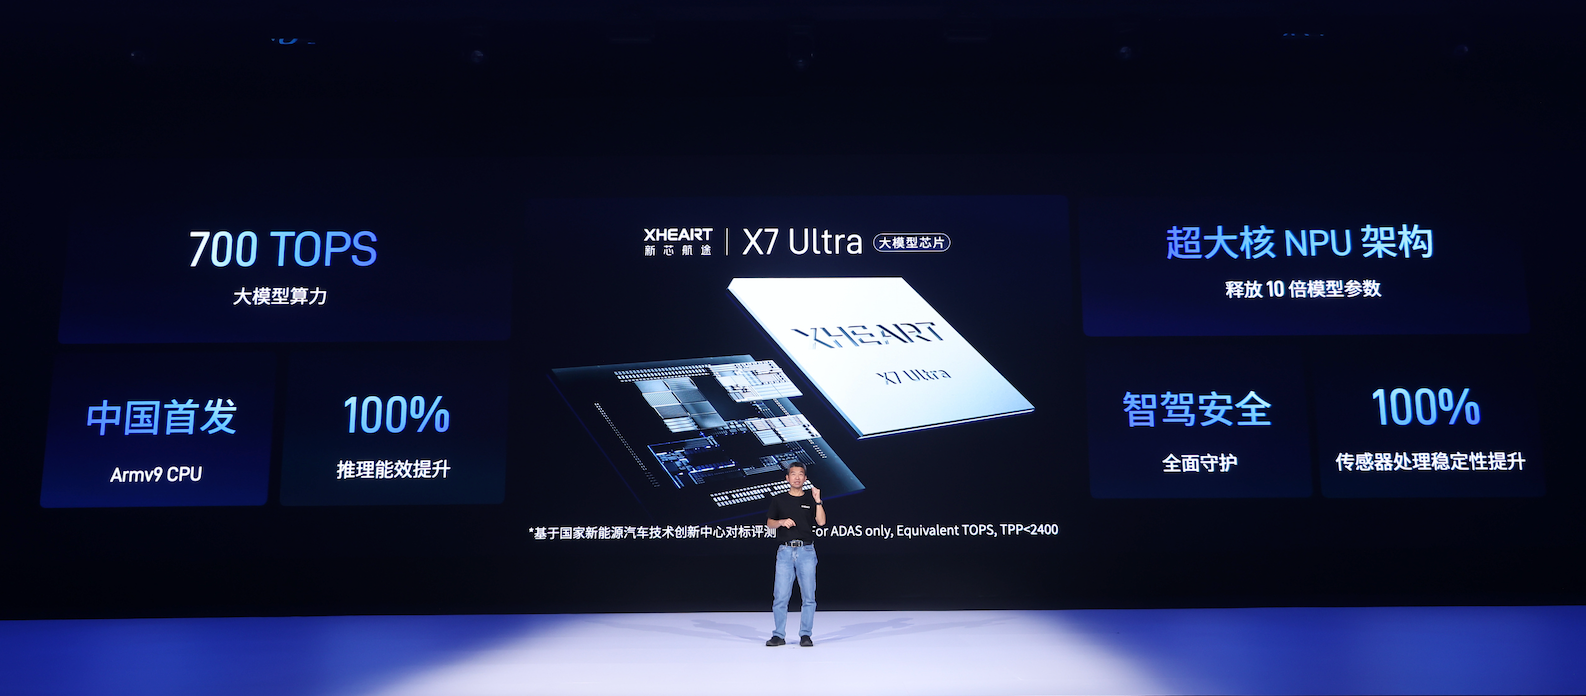
在汽车智能化从“感知控制”走向“端到端大模型”的深水区时,计算芯片行业迎来了一场深刻的范式转移。2026年10月29日,XHEART新芯航途在苏州正式发布车规级大模型芯片X7 Ultra。700 TOPS的大模型算力、98.7%的NPU计算利用率,以及支持可部署模型参数量实现10倍提升的硬核表现,不仅印证了一家初创芯片企业两年完成规模化量产的惊人速度,更在行业层面吹响了大模型定义芯片的技术变革号角。
长期以来,芯片制造与算法演进之间始终存在着一条隐形的鸿沟。传统的汽车芯片设计往往奉行硬件先行逻辑,先锁定晶体管架构与理论算力峰值,再由上层算法适配既有硬件。然而,在端到端与世界模型迅速崛起的今天,算法迭代的周期被压缩至以月、甚至以周计算,而传统芯片的研发周期长达两到三年。这种时间差直接导致了诸多高算力芯片在车端部署时陷入理论算力雄厚、真实效率匮乏的窘境。芯片的峰值算力往往难以转化为车端的实际推理效率,计算单元大量闲置,带宽瓶颈难以突破。
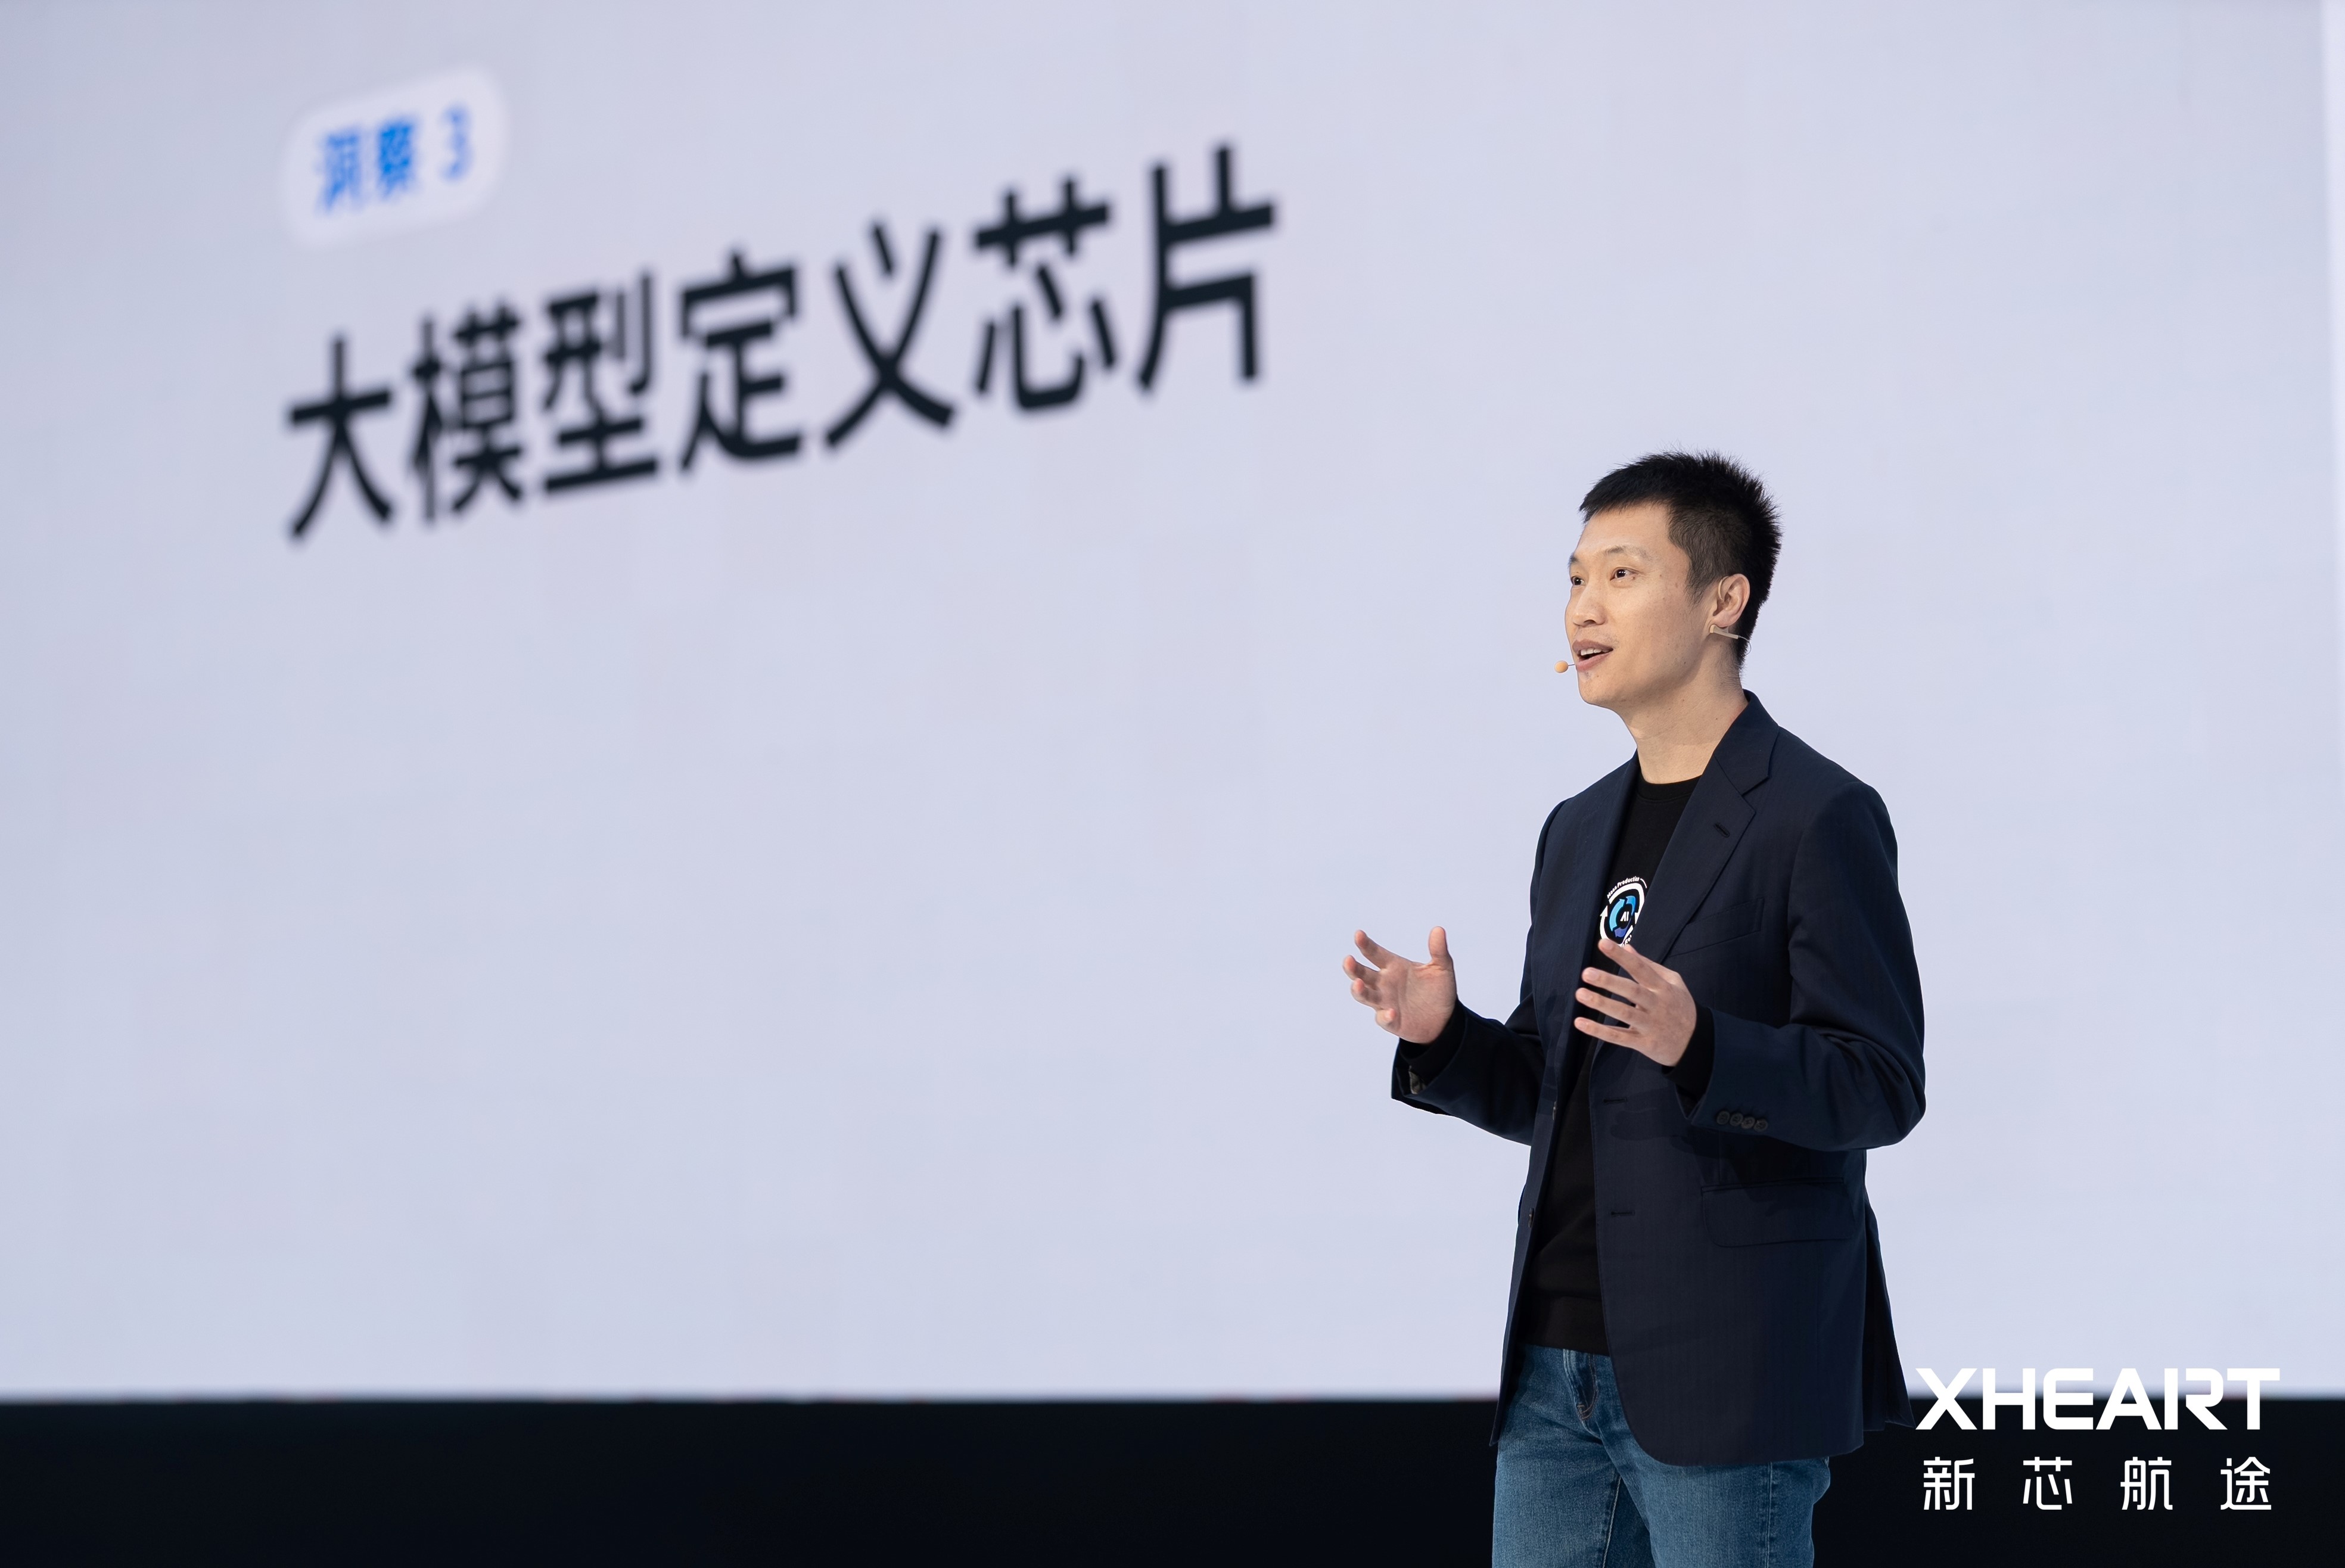
XHEART推出的X7 Ultra,其核心价值不仅在于具体的性能参数,更在于它向行业展示了一种全流程倒推的新范式。所谓大模型定义芯片,本质上是以真实量产的模型需求为原点,去重新打磨、定制芯片底层架构。当计算单元、高精度专用加速引擎以及数据流转机制在硅片蚀刻之前就与算法算子深度打通时,传统小核间百GB/s级的数据瓶颈便被超大核内部TB/s级的高速互联所取代。
同时,通过底层软硬协同与整网级融合的工具链重构,X7 Ultra实现了98.7%的NPU计算利用率,使内存带宽消耗降低80%,能效提升100%。这种架构上的协同创新,使得芯片的算力不再只是纸面上的理论峰值,而是直接转化为车端推理效率与驾乘体验的真实提升。
这一技术范式的转型,也重新定义了芯片产业链的合作生态。传统芯片厂商与算法公司之间简单的买卖关系正被彻底重塑,走向前置化的协同研发。
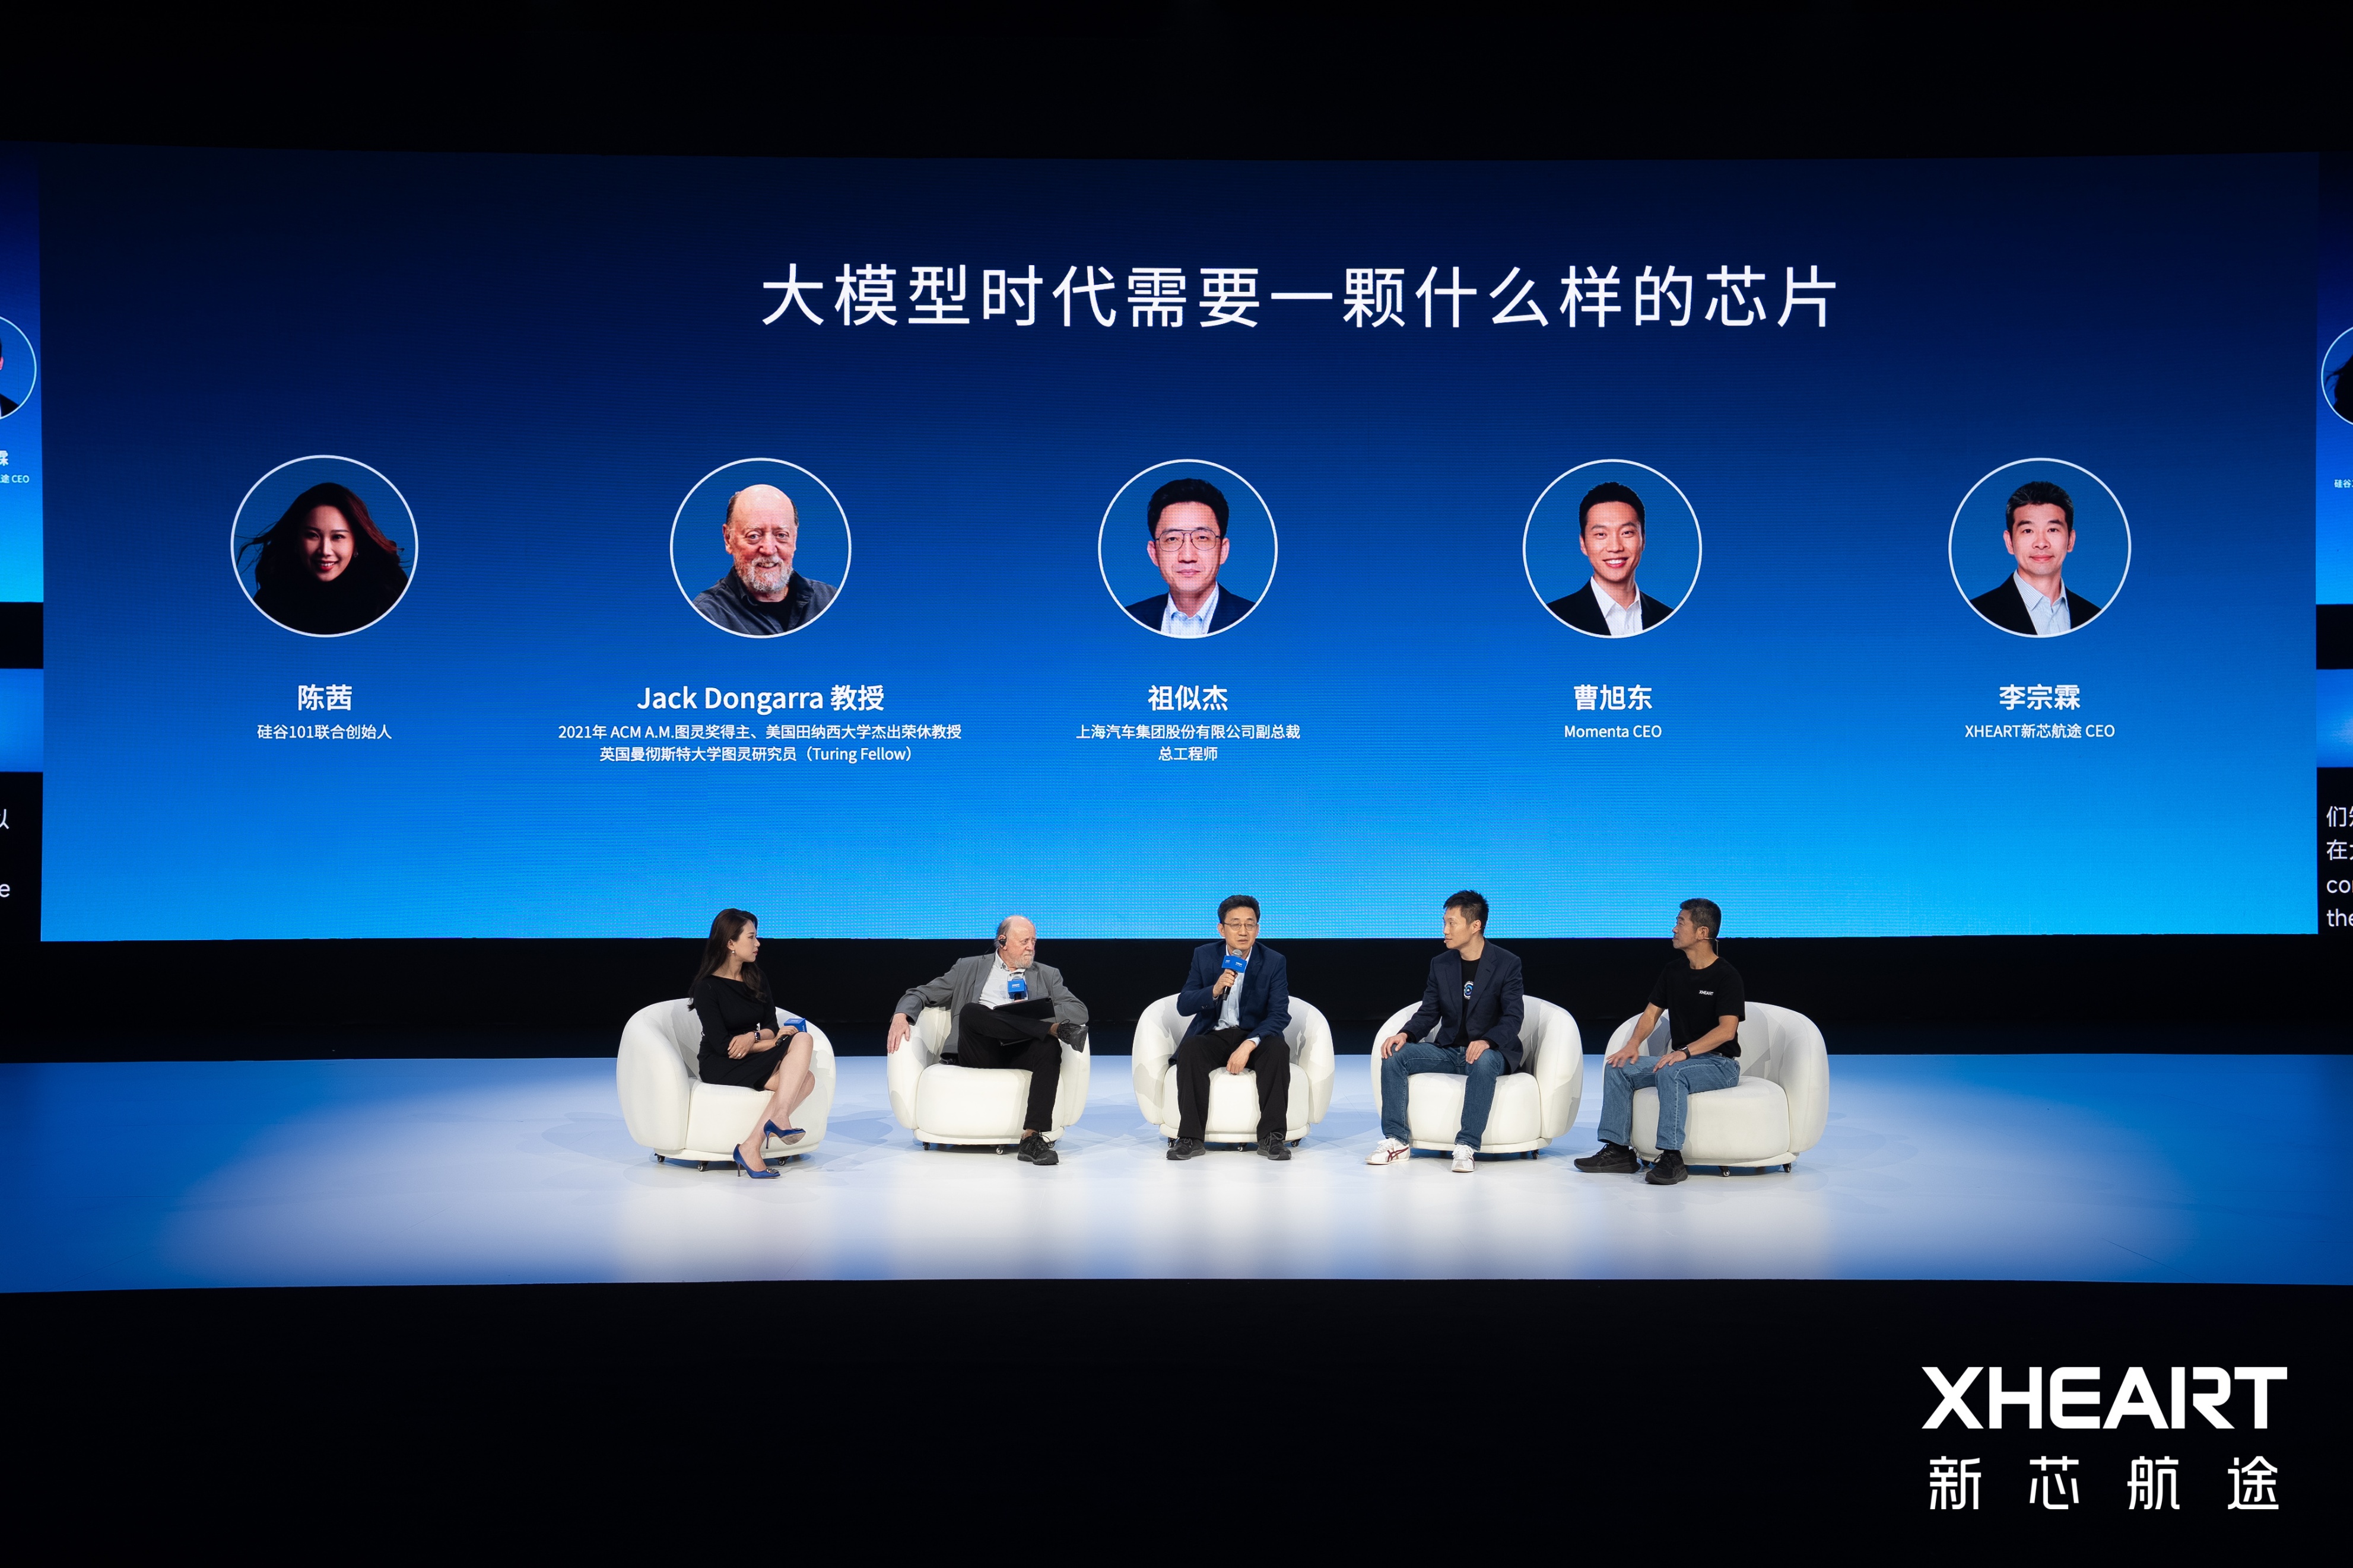
从Momenta与XHEART的深度合作来看,算法公司在芯片定义之初便将自身对未来数年模型架构的研判注入硬件底层,而芯片厂商则针对世界模型、端到端大模型的算子特征提供定制化的架构支撑。这种硅前验证与软硬协同,使得软硬件的演进频率达成高度同频,也为Momenta R7 Ultra世界模型在车端的落地提供了坚实的物理载体。大模型定义的芯片相比通用芯片性能可提升10倍,正加速推动智驾摩尔定律向前迈进。
此外,这种软硬协同正在获得整个半导体与AI学术界的共识。台积电通过先进工艺为X7 Ultra提供底层制造支持,确保高集成度与高能效的物理落地;图灵奖得主Jack Dongarra教授亦指出,在设计定型前让算法、软件与芯片团队紧密协作,改善芯片内部及芯片之间的数据搬运效率,是面向大模型时代更加行之有效的研发路线。各方的深度耦合,标志着智驾产业正从单点突破转向全栈协同的崭新阶段。
商业化的结果是检验技术路线的终极标准。成立仅两年的XHEART,X7系列芯片已实现超过20万颗的累计出货,并获得超40款车型的定点订单,涵盖双X7计算平台的L3/L4高级别自动驾驶项目。对于一家年轻的芯片初创公司而言,这样的成绩单不仅意味着大模型定义芯片的理念经受住了规模化量产的考验,也反映出整车厂与行业供应链对软硬深度融合技术路线的急迫需求与高度认可。
展望未来,智驾系统的演进正在加速迈向L3与L4的规模化落地阶段。面对百亿甚至千亿参数规模的大模型上车挑战,传统通用算力的堆砌在车端功耗、成本与散热的严苛约束下难以维系。XHEART公布的下一代X9芯片研发目标——3000 TOPS大模型算力和700GB/s单芯片内存带宽,清晰地揭示了未来的竞争焦点:唯有持续推动访存能力与计算能力的同步跨越,才能让芯片真正承载起智驾系统的下一次自我进化。
大模型时代不缺算力泡沫,缺的是能将模型潜能彻底释放的高效计算基础设施。大模型定义芯片不是一个概念的重构,而是一场关乎汽车智能化落地效率的工业革命。随着X7 Ultra的量产落地与下一代X9的研发布局,智能化赛道的底层游戏规则已经改变:未来的硅片竞争,将不再是单纯的晶体管密度和理论算力比拼,而是谁能以最深刻的模型理解,打通软件算法到硬件硅片的全栈闭环,让大模型真正走进千家万户的日常出行之中。
---------------------
不保证以上内容的真实、准确和完整。市场有风险,投资交易需谨慎。所涉标的不做任何推荐,据此投资交易,风险自担。
科记汇,设有财经科技媒体人社群,资深媒体人创办,财经科技报道先锋,年阅读观看量数亿。研究重大财经动态、企业家精神、商业文明发展历程,报道大型企业、上市公司、创业公司关键发展节点。内容同步数十家网络平台。欢迎提供报道线索和采访机会。
微信扫一扫,分享到朋友圈